想把 Obsidian 插件上架?Auto Scan 这关,我先帮你踩了
前几天打开 Obsidian 的社区插件后台,扫了一眼自动扫描报告。
过去密密麻麻的 warning,现在只剩下一条了:
README does not appear to contain English text
对,就是那个「你的 README 只有中文」的 warning。
我盯着它看了几秒,笑了一下,然后决定:这个 warning 我不修。
原因很简单:我的插件 Wechat Converter 主要就是给中文用户用的,在国内场景里跑。README 全中文,对我的用户来说反而是最自然的事。保留这个 warning,是我刻意选的。
但你千万不要以为,从「满屏飘红」到「只剩一条我故意不修」,是一条轻松的路。
这中间踩了不少坑。有些坑是 Obsidian 自动扫描特有的,有些是 AI 辅助开发这个模式下特有的。我觉得现在这个时间点,把这些坑分享出来,可能正是时候。
为什么是现在
Obsidian 插件上架的流程,最近有两个变化我觉得很值得聊。
第一个变化:自动扫描取代了人工排队。
以前你要上架,得去 obsidian-releases 提 PR,然后排队等人工 review,基本上是几个月起步,因为排队等待审核的插件实在太多了。关于这一段,我之前写过一篇[[被官方 Bot 打回 10 次后,我终于摸清了 Obsidian 插件上架的所有"潜规则"]],讲的就是上架前的那些坑。
自从 Obsidian 上线自动扫描机制以来,每个版本提交上去,机器就会自动检查安全性、代码质量和恶意行为风险。上架速度确实快了很多。但也意味着第一道门槛变成了「能不能先过 Scan」,而不是「能不能等到 reviewer 有空」。
那篇旧文讲的是 PR 校验流程的坑,这篇来讲 Auto Scan 代码审查的坑。两篇凑一起,差不多就是完整的上架避坑指南了。
第二个变化:AI 让插件开发的门槛降到了地板。
我自己就是个典型。我不是程序员,以前做产品经理,现在做 BA。这个 Wechat Converter,几乎整份代码都是在 AI 帮助下写出来的。放在两年前,我想都不敢想一个非科班的人能做出一款上架到 Obsidian 市场的插件,而且现在已经有 1 万多的下载量了。
但这两个变化叠加,也带来一个尴尬的局面:AI 擅长的是写「能跑」的代码,而不是写「能过 Scan」的代码。 因为它默认学到的是一般 Web 开发范式,不是 Obsidian 插件市场的扫描规范。
以后会有越来越多的人,用 AI 做出插件,然后想上架分享。而 Auto Scan 会是他们遇到的第一堵墙。这篇文章,就是我把这堵墙拆开给你看。
自动扫描到底在看什么
第一次跑 scan 的时候,我盯着满屏的 warning 报错愣住了。我的代码本地跑得好好的,功能也没问题,但它就是不让你过。
后来我才理解:自动扫描看的不是「你能不能跑」,而是四件完全不同的事:
- 你的实现方式是否足够安全
- 你的 API 使用是否符合 Obsidian 生态的约束
- 你的 DOM 操作、样式赋值、HTML 注入是否会触发风险
- 你的代码是否可维护、可被第三方信任
所以会出现一种很典型的情况:某段代码在一般的前端项目里非常普通,甚至是你下意识就会那么写的;但一进 Obsidian 的自动扫描,它就是 warning,甚至是 error。
因为你的写法没有对齐 Obsidian 的规则。
当然,如果你从一开始就按 Obsidian 的规范来写,很多坑是可以避开的。但如果你和我一样,是先靠 AI 把功能跑通、回头再修 Scan 的。那下面这些应该很适合你。
我们踩过的那些高频坑
下面这些是我们这轮反复撞到、改了一遍又一遍的地方。
1. 普通前端写法,在 Obsidian 里可能就是雷
这些写法,在一般前端项目里再常见不过:
element.style.padding = '12px';
element.innerHTML = '...';
confirm('确定删除?');
fetch() 传 data: 之类的复杂参数
但在 Obsidian 插件 Scan 里,这些都很容易被盯上。
我们这轮遇到最多的两类报错是:
obsidianmd/no-static-styles-assignment—— 静态样式赋值@microsoft/sdl/no-inner-html—— HTML 注入风险
表面看是 lint 规则,背后其实是 Obsidian 在逼你想清楚一件事:你的代码能不能和 Obsidian 的生态共存?你的样式会不会破坏主题兼容性?你的 HTML 操作是否可控?
2. innerHTML 要极度克制
这个点很容易被误解。有些人看到扫描规则禁 innerHTML,就一刀切全部干掉。但实际上有些场景它就是必须的,比如 Markdown 渲染后的 HTML,Mermaid 图表的渲染输出。
我们的策略不是「不用」,而是:
- 能不用就不用
- 必须用的时候,把范围锁死在渲染边界
- 在上一行加清晰的 ESLint 注释说明原因
- 补上测试,确保这个行为是有意的、可回归验证的
关键是先区分「危险的偷懒写法」和「功能必须的窄边界用法」。
3. 样式赋值这个雷区,踩得最密集
这轮改了大量直接操作 element.style.xxx 的代码。
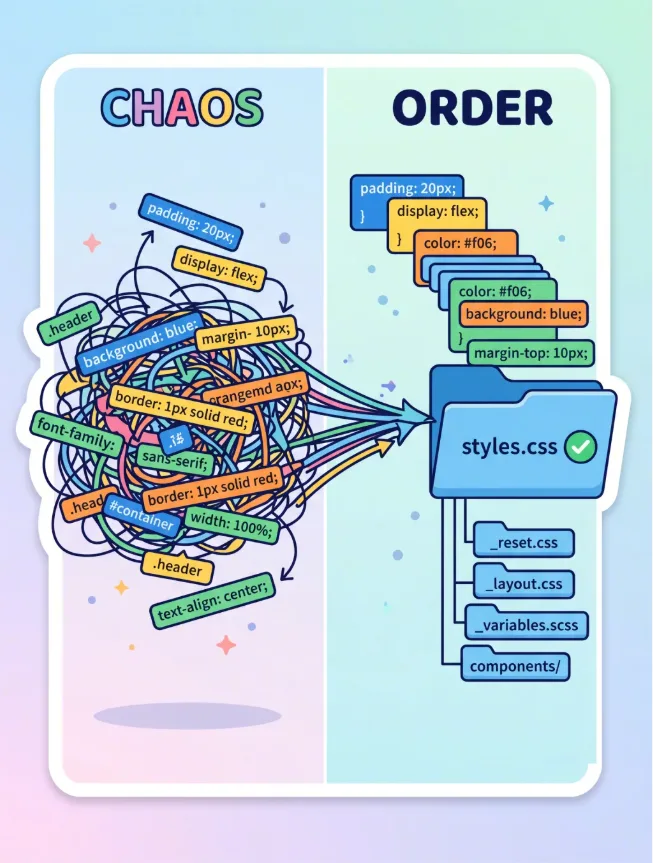
以前写的时候图省事,padding、display、color 直接在 JS 里塞。后来统一改成了:
setCssStyles(element, { ... })不只是为了过 Scan。改完之后我发现,那些以前在 JS 里凌乱的样式,其实本来就应该沉到 styles.css 里去。JS 里堆一堆 inline style,说明结构和样式的职责还没有分清楚。
4. confirm() 换成 Obsidian 原生 Modal
把删除/清空操作的 confirm() 换成 Obsidian 风格的确认弹窗。说实话,改完我自己都没想到。不只是扫过了 Scan,交互也更统一了,跟 Obsidian 本身的风格更像了。
后来我想通了一件事:Scan 规则很多时候不是在刁难你,而是在逼你把插件做得更像一个「真正的 Obsidian 插件」。
5. 关于 warning,不要觉得「没有 error 就行」
我们一开始也有过这种想法:error 必须修,warning 先放着吧。
但后来很快发现,warning 太多有三个问题:
- 扫描报告很长,看起来很吓人
- 用户如果点开看,会觉得「这个插件风险很多」
- 在插件越来越多的情况下,「看起来值不值得装」会成为用户的选择依据
所以我们后来定了三条原则:
- error 必须修
- 低风险、行为等价的 warning 尽量修
- 可能伤及核心功能的 warning,明确评估后再动
真正花时间的,是修「边界」
如果只看提交记录,你会以为我们做了很多零碎的修复:改样式赋值、补注释、换 Modal、调 manifest 版本号、修图片处理、拆模块……
但站在更高一层看,所有这些修复指向的是同一件事:
把「随手可写的实现」,改造成「边界清晰、可解释、可测试、可过 Scan 的实现」。
这也是为什么中途我们不断在拆文件、拆模块、解耦逻辑。因为如果一个文件越来越大,自动扫描暴露出来的问题会越来越难修:你已经说不清哪一段是业务,哪一段是渲染边界,哪一段是兼容补丁。
后来我们给 Codex 立了一条硬原则:
不要往单个文件里继续堆代码。优先模块化和职责解耦。
这条原则,对过 Scan 本身也有帮助。
如果你也准备上架插件,我的建议
1. 把 Scan 当作开发流程的一部分
不要等到准备发 release 了才第一次跑扫描。
更好的做法是:
- 日常开发时跑一个快的检查命令
- 合并前跑完整的扫描
- CI 里也跑同一套检查
- 发版时再验证一次
这样能避免一种特别痛苦的情况:你已经写完了一大堆功能,才发现你的实现方式和扫描规则根本冲突。
2. 给项目留一份 Obsidian Scan Checklist
这次踩过的坑,我们后来在项目里留了一份 checklist.md,列了十几条规则,每次 release 前对着跑一遍。
它的价值不在于「记规范」,而在于给三类人看:
- 未来的自己
- 一起协作的 AI
- 其他协作者
很多坑踩过一次,就应该把它固化下来,不要靠记忆。
说到这个,我其实还有一个小建议。
3. 不要让 AI 自由发挥
AI 很适合加速开发,但前提是你给了它足够明确的约束。
至少你要告诉它:
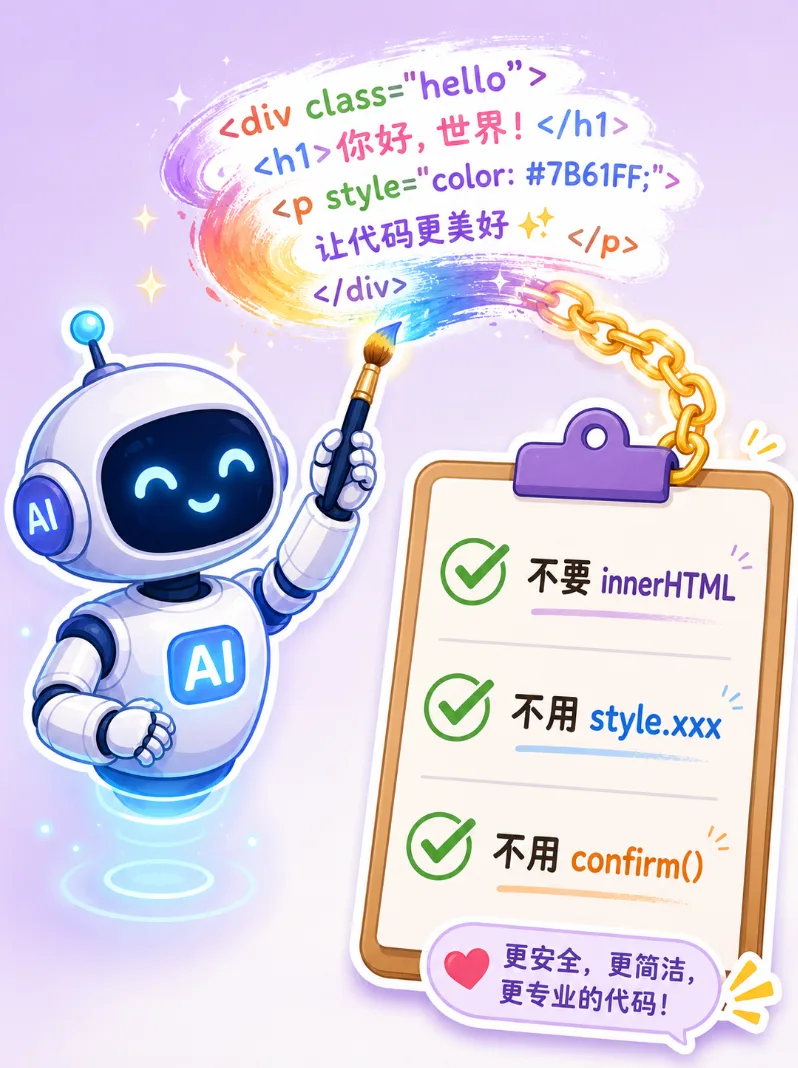
- 不要直接写
innerHTML,除非明确说明原因 - 不要静态写
element.style.xxx - 不要用浏览器原生
confirm() - 优先用 Obsidian 原生 UI 组件
- 新逻辑尽量拆模块,不要继续往入口文件里堆
- 改核心逻辑必须补测试
如果没有这些约束,AI 很容易生成「在 Web 世界里合理、但在 Obsidian 市场里高危」的代码。
以前,插件作者最大的难题是「怎么做出来」。
现在,越来越多人的难题会变成「怎么做得能上架、能被信任、能长期活下去」。
但 Wechat Converter 这一路走过来,意味着 Obsidian 的插件生态正在从一个「野蛮生长」的阶段,进入「基础设施化」的阶段。
而自动扫描,就是这套基础设施里最关键的一层。
如果你愿意把它当成一种倒逼,你最后得到的,往往不只是一个「通过审核的插件」,而是一套更成熟的开发习惯:
- 更清晰的边界
- 更克制的实现
- 更稳定的架构
- 更可信的交付
嗯,和一个你可以刻意保留的 warning,哈哈哈
Wechat Converter 是一个将 Obsidian Markdown 转为公众号格式、并可一键发送到微信后台的插件。如果你恰好也在写公众号、同时用 Obsidian 做笔记,可以在 Obsidian 插件市场搜索「Wechat Converter」找到它。
这篇文章是「踩坑系列」的一部分。之前写过上架时被 Bot 打回 10 次的经历、插件被误下架的来龙去脉,感兴趣的话可以翻翻历史记录。
这篇属于 Obsidian 相关教程。想按顺序学习,可以回到完整的 Obsidian 入门教程路径。
热衷于用大白话和工程化消除生活与工作中的“不顺手”。在微信公众号持续记录能省下时间的实操笔记、AI 提效技巧与小工具。